SFT 为什么"学不会":不完整学习现象(ILP)的系统性研究
论文:Why Supervised Fine-Tuning Fails to Learn: A Systematic Study of Incomplete Learning in Large Language Models 作者:Chao Xue, Yao Wang 等(UNSW / 腾讯混元 / 腾讯元宝 / UESTC / 北京大学),2026 本地文件:
research_files/papers/Xue 等 - 2026 - Why Supervised Fine-Tuning Fails to Learn A Systematic Study of Incomplete Learning in Large Langua.pdf论文链接:ACL 2026 · arXiv:2604.10079 校验说明(2026-09-17):以下区分论文报告的结果与笔记中的解读;原文存在的指标口径、表文不一致等问题保留说明,不自行补全实验细节。
一句话总结
SFT 训练 loss 收敛 ≠ 每条训练样本都被稳定掌握。论文系统研究了不完整学习现象(Incomplete Learning Phenomenon, ILP):在其多选题化、重复采样的检测协议下,10 个基准 SFT 数据集平均有 15.3% ± 2.1% 的监督样本被判为未学会(§3.1.4)。作者提出“检测 → 归因 → 定向干预”框架,研究 5 类可能成因;这个比例是特定评测协议下的实验结果,不能直接当作所有 SFT 模型的自由生成错误率。
1. 什么是 ILP
定义:SFT 整体训练 loss 稳定后,重新评估模型自己的 SFT 训练样本,仍有一部分监督信号无法被稳定恢复。作者报告这种现象跨随机种子和采样评估设置复现。整体收敛不等于每个长尾样本都获得了充分优化,因此“优化不足”仍是后续考察的成因之一。
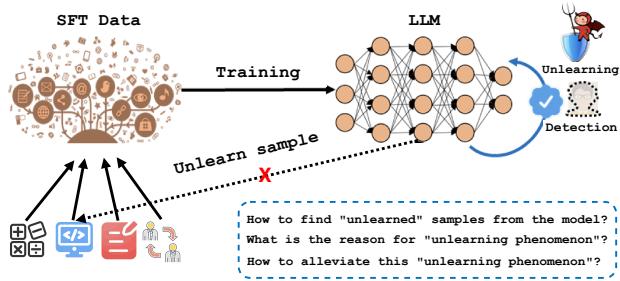
注意区分三个概念:
| 概念 | 含义 | 与 ILP 的区别 |
|---|---|---|
| 灾难性遗忘(Catastrophic Forgetting) | 丢了之前已学会的能力 | 关注能力随训练丢失;ILP 关注 SFT 结束后监督样本是否被稳定掌握,两者不应简单视为互斥 |
| 机器遗忘(Machine Unlearning) | 主动擦除特定知识 | ILP 是被动、非预期的学习失败 |
| ILP | SFT 后仍无法稳定恢复部分训练监督 | 检测对象是训练集本身;不等于只有 held-out 集表现不好 |
论文引言将 ILP 与灾难性遗忘区分,但 §3.2.4 又把“先学会、后被覆盖”的左侧遗忘列为成因。因此不能把 ILP 一概定义成“从未学会、绝非遗忘”。
为什么值得关心:
- SFT 数据(尤其医疗、法律等专家领域)标注成本高,没学会 = 直接浪费;
- 未学会样本不是随机的——集中在罕见案例、组合模式、知识密集样本上,恰好是最影响可靠性的部分;
- 聚合指标会掩盖 ILP:benchmark 总分在涨,特定的监督样本可能持续失败。
2. 如何检测"未学会"样本
整体框架分三阶段:SFT 训练 → 未学会样本检测 → 校准修复。
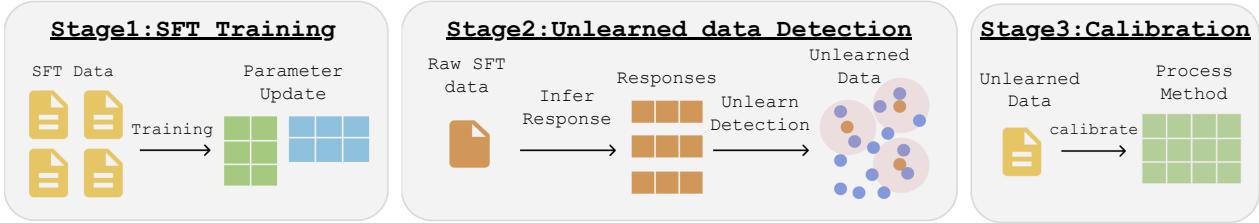
2.1 自由文本 → 多选题(MC)化
SFT 响应是自由文本,样本级对错难以标准化判定。论文把每条 SFT 样本转成多选题:原响应作为正确选项,另构造若干语义合理但错误的干扰项。此转换只用于检测,不改变 SFT 训练目标。
这测量的是在候选答案中恢复监督内容的能力,不能直接等同于无候选项时的自由生成能力;干扰项质量、选项位置等也可能影响结果。
2.2 收敛后重评估 + 稳健判定
训练集准确率:
其中,N 是训练样本总数,i 是样本编号,k 是候选选项编号;\hat y_{i,k} 是模型对第 i 条样本的选项 k 给出的预测概率,y_i 是正确选项编号。\arg\max 选出预测概率最大的选项,\mathbb I(\cdot) 是指示函数:条件成立取 1,否则取 0。因此,\mathrm{Acc} 就是整份训练集上答对的样本比例。
单次准确率太粗,混入随机性,因此用重复采样:
- 论文所称 pass@N:对同一条样本做 N 次独立推理,答对次数除以 N,衡量监督信号被恢复的一致性。这里的 N 是该样本的推理次数,与上面准确率公式中表示训练样本总数的 N 含义不同。这是原文 §3.1.3 的定义,不同于通常 pass@k 的“k 次采样至少一次成功”口径,使用时应注明区别(常见定义见 HumanEval 论文 §2.1)。
- Best-of-N(BoN):取 N 次中置信度最高的预测,作为补充诊断。作者称其为能力的“上界估计”,但按置信度选择仍可能选错,不构成严格的能力上界。
- 判定阈值 T(threshold):用于判断一条样本是否“未学会”的答对比例阈值。判定条件是 \mathrm{pass@N}(x) < T,其中 x 是被检测的样本;论文取 T=0.2,即答对比例**严格低于 20%**才满足该条件。仅以 5 次独立推理说明比较规则:0 次答对时 0/5=0<0.2,满足条件;1 次答对时 1/5=0.2,不满足严格小于条件。
- 采样设置:论文使用 BoN-5;§3.1.4 表述为在重复 BoN-5 采样下筛选 pass@5 低于阈值的样本。原文没有充分说明两层采样如何组合,复现时不能只凭这句话确定完整实现;上面的算例只解释阈值比较,不补全这一采样流程。
- 归因样本:再按错误的一致性选择最严重的 Top-K,主实验 K=1000(§3.1.4)。后续重点诊断的样本并非对全部训练数据的无偏随机抽样。
论文报告的普遍性结果:在 10 个基准 SFT 数据集上,平均 15.3\% \pm 2.1\% 的监督样本在该协议下被判为未学会;实验覆盖 Qwen / LLaMA / OLMo2 等模型及不同领域。原文 §3.1.4 未说明 \pm 2.1\% 是标准差、标准误还是置信区间,不能自行解释其统计含义。
2.3 归因用的两个诊断信号
- 知识存在性:SFT 前先测基座模型 zero-shot 能否答对,\mathcal{P}_{\mathrm{exist}}(x) = \mathbb{I}\left(\mathrm{Acc}(\mathcal{M}_{\mathrm{base}}(x)) > 0.8\right);
- 分布偏移:基座与 SFT 后模型预测分布的 JS 散度 D_{\mathrm{JS}}(P_{\mathrm{base}} \| P_{\mathrm{SFT}})。
两者为“知识不足”“冲突先验”“更新不足”等假设提供线索,还需结合数据检查、训练顺序和干预结果归因。答不出不严格等于知识不存在,JS 散度大也不单独证明知识冲突;它们是可观测的代理信号。
3. 五大成因与定向干预(核心)
论文图 3 用“知识 × 对错”示意不同成因。结合 §3.2 的诊断流程,应将其理解为对基座相关知识及其正确性的检查,而不是“横轴看基座、纵轴看 SFT 后是否答对”:进入归因流程的样本已经是 SFT 后未稳定掌握的样本。
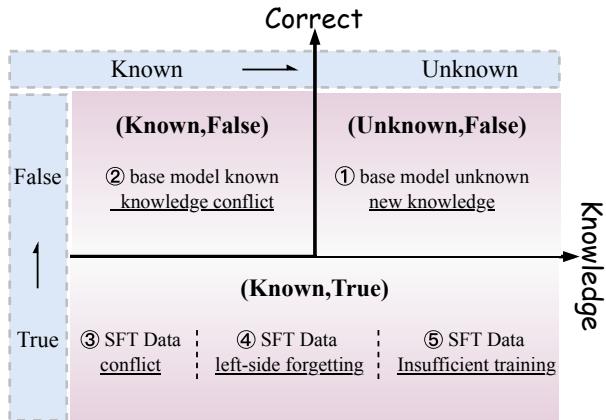
- (Unknown, False):基座缺少相关知识且答错,优先检查成因① 知识缺失;
- (Known, False):基座有相关先验,但与监督答案冲突,优先检查成因② SFT 与基座冲突;
- (Known, True):基座具有正确的相关知识,但 SFT 后监督仍未被稳定恢复,继续检查成因③ 数据内部冲突、④ 左侧遗忘、⑤ 训练不足。
图 3 是示意分类,不能替代完整判定程序;其中 Known 也不能机械等同于式(2)的 \mathcal{P}_{\mathrm{exist}}=1,因为式(2)本身已经使用了答对率阈值。作者把干预视为检验归因合理性的实验,并未证明这些原因彼此独立或覆盖全部失败。
① 预训练知识缺失 → 继续预训练(CPT)注入知识
诊断:用 OpenIE 把未学会样本抽成主-谓-宾三元组,得到候选知识集 \mathcal{K}_{\mathrm{cand}};对每条知识探测,满足
即按论文的操作性标准判为盲区知识(§3.2.1,式(4))。反复失败支持“知识不足”的解释,但不构成排除提示方式、推理失败等其他因素的证明。
干预:对每个未知实体检索 WikiData / Google / o1 等外部来源(平均 20 \pm 1.1 篇相关文档),构建知识增强语料 \mathcal{C}_{\mathrm{aug}},按比例混合后做 CPT,再重新 SFT:
附录 A.3 说明,增强语料侧重背景概念,避免直接复制原未学会样本的内容。0.8/0.2 是本文使用的混合比例,不是经过普遍验证的最优配方。
效果:正文 §4.1 报告 MedQA / LegalBench / FinanceBench 等任务提升 +9.4%~+14.1%,例如 MedQA +12.5%(此处沿用原文标记,图 4 未逐柱标出精确数值)。注意图 4 的指标并不统一:MedQA 为 Accuracy、LegalBench 为 F1、TechFAQ 为 pass@5、FinanceBench 为 EM,不能全部称为准确率提升。下文表 4 则明确区分准确率增量与覆盖率。
增加 SFT epoch 的对照实验(附录 A.4,表 4):
| MedQA 设置 | Acc 相对基线的增量(百分点) | Learn Rate(%) |
|---|---|---|
| SFT 2 epoch | 0(增量基线,不是准确率为 0) | 65.3 |
| SFT 10 epoch | +1.2 | 66.8 |
| CPT + SFT | +8.3 | 82.1 |
Learn Rate 在文中被解释为知识盲区覆盖率:增加 epoch 提升 1.5 个百分点,CPT + SFT 提升 16.8 个百分点;它与 Acc 列的 +1.2 / +8.3 不是同一指标,也不能与图 4 的 +12.5 混为一组实验。
可支持的结论:在本文的模型、数据和 2→10 epoch 设置下,单纯延长 SFT 的收益有限,补充背景语料后 CPT + SFT 更有效。作者将其称为某种“不可学性”,但这不能证明 SFT 普遍无法学习新知识,也不能证明 CPT 是唯一可行方法;两种方案还同时改变了数据与训练计算量。
② SFT 监督与基座知识冲突 → CPT 校准
诊断:作者观察到,基座模型对错误答案置信度很高时,后续 SFT 可能难以纠正。记输入的多选题为 x、基座模型预测的答案为 \hat y、SFT 数据提供的正确答案为 y_{\mathrm{SFT}},高置信错误判定为(§3.2.2,算法 2):
公式中的符号含义:
| 符号 | 含义 |
|---|---|
| P_{\mathrm{base}}(\hat y \mid x) | 给定题目 x 时,基座模型为自己预测的答案 \hat y 分配的概率,用作置信度;下标 base 表示基座模型,\mid 表示“给定……条件下”。原文具体提取的是预测答案 token 的概率,正文及算法 2 记为 P_{\mathrm{model}},本笔记写成 P_{\mathrm{base}} 以明确模型身份。 |
| T_{\mathrm{conf}} | 高置信度阈值;conf 是 confidence(置信度)的缩写。只有预测答案的概率超过这个阈值,才符合这里的“高置信”条件。 |
| \hat y \neq y_{\mathrm{SFT}} | 模型预测与监督提供的正确答案不同,即答错。 |
| \mathrm{Error}(x) | 高置信错误的指示值:同时满足“高置信”和“答错”时为 1,否则为 0。取 0 也可能是低置信度的错误,并不保证答对。 |
例子(仅用于说明):正确答案是 B,基座模型却选 A,并给 A 分配了 0.95 的概率。若设 T_{\mathrm{conf}}=0.9,则 0.95>0.9 且 A \neq B,所以 \mathrm{Error}(x)=1。这里的 0.9 是算例设定,不是论文报告的实验参数。
满足条件的样本构成高置信错误集 \mathcal{E}。需要区分:第 2 章的 pass@N 统计的是多次推理实际答对的比例,与 T=0.2 比较;这里的 P_{\mathrm{base}} 是模型对所选答案给出的概率,与 T_{\mathrm{conf}} 比较。模型可以对错误答案给出很高的概率,所以这两种量及其阈值不能混用。
干预:对冲突样本从 Wikipedia / 领域语料检索权威信息,同样走"混合语料 + CPT"流程,先校准基座内部知识表征,再 SFT。
效果:ARC / CommonsenseQA(表中简写为 CommonQA)/ SocialIQA / MedMCQA 上,表 1 的准确率提升为 1.6~2.8 个百分点;表 6 的冲突率绝对下降 2.5~4.0 个百分点。例如 12.3% → 8.8% 是下降 3.5 个百分点,而非相对下降 3.5%。
③ SFT 数据内部冲突 → 冲突检测 + 动态分桶
问题:语义相似甚至几乎相同的输入配了矛盾标签,模型收到不一致的学习信号。
干预(两阶段):
- 冲突检测:用 Sentence-BERT 计算样本对语义相似度,\mathrm{Sim}(s_i, s_j) > X 的候选对交给外部模型判对错——错的删除;两条都被判为正确、但仍存在冲突的样本则保留。正文提到 GPT / DeepSeek,附录 C.2 具体写 GPT-4;相似度高本身不代表标签一定矛盾。
- 动态分桶(bucketing):把冲突样本对分进不同 bucket,保证它们不出现在同一个 mini-batch;每 K 步重新评估一次分桶。
效果:表 2 中 Qwen-7B 82.3% → 85.1%(+2.8 个百分点)。表 8 的同模型消融中,分桶为 +2.2、删除为 +1.5 个百分点,支持在这些实验中保留有效监督并分桶的做法。分桶能减轻更新干扰,但不能从逻辑上消除同一输入的不可兼容标签;仍需检查上下文是否缺失。
④ 左侧遗忘(Left-side Forgetting)→ 全局 shuffle + 动态重采样
问题:多数据集顺序拼接训练时,早期样本可能被后续更新覆盖。作者通过反转数据集顺序并跟踪各子集准确率,观察到偏向近期数据的现象(§3.2.4);这支持训练顺序效应的解释,不代表已排除所有其他因素。
干预:
- 整个 SFT 数据集全局随机 shuffle;
- 动态重采样:每 K=500 步监测各数据子集的验证准确率,若某子集相对下降超过 5%,临时上采样该子集。
效果:表 2 的准确率提升为 1.2~1.5 个百分点。摘要实验的表 11 中,前 10% 数据 ROUGE-L 从 0.41 → 0.53,绝对增加 0.12,相对提升约 29%;中段 0.57 → 0.59,相对 +3.5%;末段 0.61 → 0.60,相对 −1.6%。这些是该实验的顺序分段结果,不是所有 SFT 任务都具有的固定收益。
⑤ 训练不充分 → 渐进式 epoch + 早停
问题:罕见、长尾、结构复杂的模式在固定 epoch 下吃不到足够梯度。
干预:从较小 epoch 数开始,根据验证集表现决定是否增加训练轮次。正文 §3.2.5 给出的损失停止条件为
本质是按验证表现调整训练时长。原文实现口径存在差异:式(7)只在验证损失比上一轮增加超过 \delta 时触发;附录算法 5 则从 E=1 开始,在验证性能不再优于历史最好值时停止。两者对平台期的处理并不等价,复现时需明确选择。
效果:按表 2,四个模型的准确率分别提升 1.9 / 1.8 / 1.9 / 1.9 个百分点,范围是 1.8~1.9 个百分点(如 Qwen-7B 88.2% → 90.1%)。正文 §4.5 写成 1.0~1.9,与表格不一致;本笔记采用可由表内数值核算的范围。
五类成因速查表
| # | 成因 | 诊断信号 | 干预 | 典型提升 |
|---|---|---|---|---|
| ① | 基座知识缺失 | pass@10 < 0.2 且 BoN-5 Acc < 0.1 | 检索增强语料 + CPT(0.8/0.2 混合) | 正文报告 +9.4%~+14.1%(沿用原文口径;各任务指标不同) |
| ② | SFT 与基座冲突 | 高置信预测且与监督标签不同 | 权威语料 CPT 校准 | 准确率 +1.6~2.8 个百分点(表 1) |
| ③ | 数据内部冲突 | 语义相似对 + 外部模型核验 | 删错样本 + 冲突对动态分桶 | 准确率 +2.5~2.9 个百分点(表 2) |
| ④ | 左侧遗忘 | 反转顺序后的子集表现变化 | 全局 shuffle + 动态重采样 | 准确率 +1.2~1.5 个百分点;早期数据 ROUGE-L 相对 +29% |
| ⑤ | 训练不足 | 长尾/复杂模式残余误差 | 渐进 epoch + 验证早停 | 准确率 +1.8~1.9 个百分点(表 2) |
各行对应不同实验和评估集合,不能把提升值直接相加,也不能将其解释为未学会样本比例下降了同样数值。
4. OLMo2-7B 上的深入分析(附录 F,值得单独看)
作者利用开放语料进行“SFT 知识 vs 检索所得预训练片段”的比对:先针对每个 SFT 数据集的主题,用 Elasticsearch 检索 Top-100k 片段,再为具体知识项做 Sentence-BERT 语义匹配,最后由 GPT 判断是否存在或冲突(附录 F.2)。
语料背景需核对:本文将 OLMo2-7B 的语料写作“Dolma,5T token”,但 Ai2 官方 OLMo-2-1124-7B 模型卡列出的第一阶段为约 4T token 的 OLMo-Mix,第二阶段为 Dolmino-Mix;5T 是该表中 13B 模型第一阶段的训练量。笔记不应把本文的这句话当成已核实的模型事实,实际检索语料与模型训练语料的对应关系也需澄清。
结果一:检索评估中的未发现与冲突。 表 13 在 35,000 条 SFT 知识项上报告总体“知识不存在率” 19.3%、冲突率 14.5%;专业知识类为 27.4% / 18.4%。这里的“不存在”是在相关检索片段中未找到,不能证明整个预训练语料都没有,也不等于模型参数中完全没有相关知识;它与模型推理失败率是不同口径。
结果二:表 10 的成因比例存在统计口径缺口。 原表列出:
| 成因 | 原表报告比例 |
|---|---|
| ① 基座知识缺失 | 18.7% |
| ② SFT-基座冲突 | 13.2% |
| ③ 数据内部冲突 | 14.1% |
| ④ 左侧遗忘 | 17.4% |
| ⑤ 训练不足 | 14.6% |
| 合计 | 78.0% |
原表没有充分交代分母、类别是否互斥及为何不合计 100%,不能直接作为“OLMo2 未学会样本的完整成因分布”,也不能自行补出“其他 22%”。这五个数值不足以支持“成因占比均匀”的统计结论。更稳妥的认识是:论文考察了多种失败机制,不同干预的效果依赖具体问题。
结果三:本次 OLMo2 CPT 实验出现广泛评测退化。 表 14 所列六个 benchmark 均下降,包括 MMLU −3.5%、GPQA −6.8%、MMLU-Multi −8.1%。这里沿用原表的 \Delta\% 标记;原文未给出对应的前后绝对分数及充分的计算说明,不擅自换算为百分点。
“整合新知识导致表征调整”是作者提出的解释假设;文中没有通过恢复曲线证明下降是暂时的,也没有证明缺失率/冲突率与降幅存在单调或因果关系。结果支持对 CPT 后的通用能力进行监测,不能外推为 CPT 必然伤害通用能力。正文 §4.1、§5 关于保持或改善通用能力的概括,也应结合这组负面结果阅读。
附录 F.4、表 15 给出时效性事实、术语、多语言和文化语境等定性示例,描述输出向 SFT 版本靠拢的倾向;它们不是逐项给出准确率的量化实验,“更符合监督内容”也不能自动等同于“事实更正确”。
5. 个人启示
以下是基于论文的实践解读,不是作者已验证的通用配方:
- 把训练样本恢复能力纳入 SFT 验收。除整体 loss 和 held-out 分数外,抽查训练样本的持续失败;MC 检测宜与自由生成评估互相补充。重复采样和干扰项构造都有成本,不能直接认定该协议“成本不高”。
- 先诊断,再选择干预。表 4 的 MedQA Acc 增量为:延长 SFT +1.2、CPT + SFT +8.3 个百分点,支持在该设置下补充背景知识的价值;但数据量、检索和训练预算并不相同,不能据此得出固定的成本排序或普遍优劣结论。
- 数据审计同时检查错误标签、缺失上下文和冲突监督。语义相似度可筛选候选对,再通过模型或人工核验;分桶值得作为减轻更新干扰的候选策略。
- 领域知识不足时,将 CPT → SFT 作为可比较的方案。同时比较补充 SFT 数据、改变训练安排等方案,并监测目标任务和通用能力;不能把“需要新知识”直接推导成“必须先 CPT”。
局限性(论文自述)
- 冲突检测依赖外部工具与标注质量(GPT 判定、检索源),噪声源会降低检测准确率;
- CPT 注入的知识语料若有偏/有噪,偏差会传播到后续微调阶段;
- CPT + 重采样增加了可观的计算开销,对资源有限的团队不友好。
阅读与复现时需要保留的疑点
- 检测协议:本文 pass@N 的定义不同于常见 pass@k;pass@5 与 BoN-5 的组合、\pm 2.1\% 的统计含义交代不足。MC 判别失败也不能独自证明知识缺失。
- 数值与口径:表 10 比例仅合计 78%;§4.5 的 1.0~1.9 与表 2 的 1.8~1.9 不一致;表 14 未提供足够信息区分相对百分比和百分点变化。
- 算法细节:正文描述动态分桶,但算法 3 没写出周期重评估循环;附录 D 的 5% 阈值被称为相对下降,算法 4 却直接比较准确率差;式(7)与算法 5 的停止条件也不同。实现时应明确补充选择,不能当成论文已经给出了唯一实现。
- 归因强度:检索未发现、模型答错、语料确实不含知识是不同命题;增加数据与算力后的改善也不足以单独证明唯一成因。
- 外部背景与解释:OLMo2 语料描述与官方模型卡不一致;CPT 退化的“表征重构”解释和定性案例不应升级为已验证的机制结论。
参考文献
[1] Xue, C., Wang, Y., Liu, M., et al. Why Supervised Fine-Tuning Fails to Learn: A Systematic Study of Incomplete Learning in Large Language Models. ACL 2026, pp. 30186–30213. arXiv:2604.10079.
[2] Li, C.-A., & Lee, H.-Y. Examining Forgetting in Continual Pre-training of Aligned Large Language Models. 2024. 原论文引用的文献题名并非 Left-side Forgetting。
[3] Ai2. OLMo-2-1124-7B Model Card. 用于交叉核对训练语料与 token 数。
[4] Chen, M., et al. Evaluating Large Language Models Trained on Code. 2021. 用于区分通常的 pass@k 与本文的指标定义。
评论(0)